Por que os provedores de hiperescala estão investindo US$ 220 bilhões em infraestrutura própria?
Publicado em:Sumário executivo: A Amazon acaba de anunciar um investimento recorde de US$ 220 bilhões em inteligência artificial para 2026 — e, mesmo assim, a empresa afirma que ainda enfrenta limitações de capacidade. Esse paradoxo está no cerne da maior transformação de infraestrutura da história dos data centers: os operadores de hiperescala estão abandonando o modelo de "comprar o que precisa" e construindo seus próprios impérios do zero. Este artigo examina por que os hiperescaladores estão migrando para infraestrutura própria, para onde está indo o dinheiro e o que isso significa para a cadeia de suprimentos de data centers.
Navegação Rápida
- 1 A Grande Virada: Da Compra à Construção
- 2 O que é que 220 mil milhões de dólares realmente compram?
- 3 A Perspectiva da Infraestrutura de Cabeamento Sobre a Qual Ninguém Fala
- 4 Geografia, Água e o Novo Cálculo de Seleção de Sítios
- 5 O que isso significa para compradores corporativos e parceiros de canal?
- 6 A Perspectiva do Fornecedor de Cabeamento: Como a AMPCOM se Encaixa
- 7 Principais conclusões e perguntas frequentes
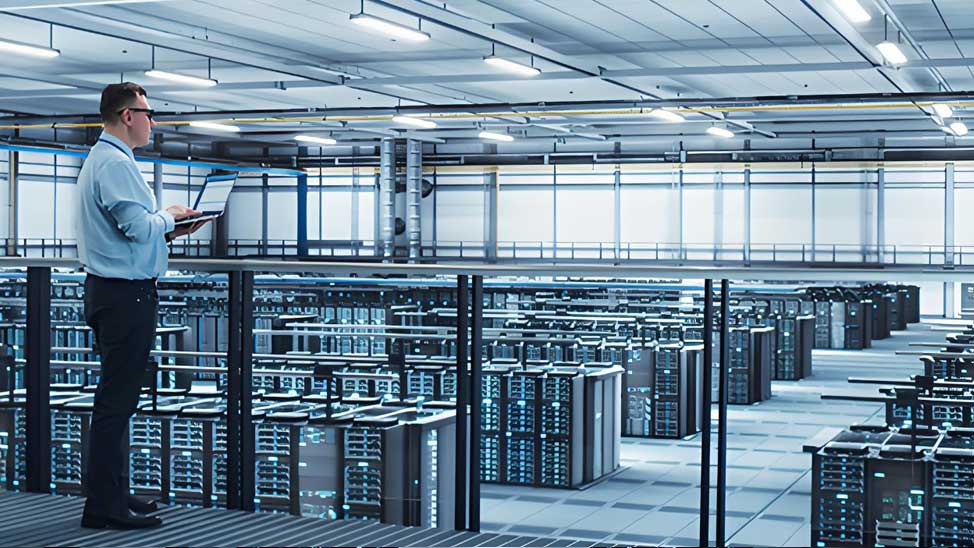
Os modernos campus de hiperescala são projetados para densidades de energia que exigem infraestrutura construída especificamente para esse fim — desde refrigeração até interconexões de alta velocidade.
Capítulo 1: A Grande Virada — Da Compra à Construção
Por que o modelo de "compra" chegou a um impasse?
A mudança não aconteceu da noite para o dia. Durante anos, a Amazon Web Services cresceu alugando capacidade de servidor — e esse modelo fez da AWS a unidade de negócios mais lucrativa da história da empresa. Mas, à medida que as cargas de trabalho de IA explodiram em escala e especificidade, os cálculos mudaram completamente.
A colocation tradicional foi projetada para cargas de trabalho de uso geral: servidores web, bancos de dados, computação padrão. Clusters de treinamento de IA — particularmente aqueles que executam sistemas Nvidia GB200 NVL72 — exigem mais recursos. 120 kW ou mais por rack — são algo categoricamente diferente. Eles exigem:
- Fornecimento de energia personalizado — Os projetos padrão de 10 a 15 kW por rack não suportam configurações com alta densidade de GPUs sem repensar todo o caminho da PDU até o servidor.
- integração direta de resfriamento líquido — Trocadores de calor na porta traseira e resfriamento direto no chip não são opcionais nessas densidades.
- Requisitos rigorosos de latência de rede — A comunicação GPU-para-GPU em clusters de IA exige comutação em sub-microssegundos e largura de banda massiva entre os nós.
- Reservas de capacidade previsíveis e de longo prazo — Os treinamentos de IA são planejados com meses de antecedência; esperar pela disponibilidade de espaço em nuvem não é uma opção.
Ao construir um cluster de treinamento com 25,000 GPUs que precisa de 300 MW de energia, a colocation padrão simplesmente não atende às necessidades. É por isso que Amazon, Microsoft, Alphabet e Meta optaram por campus de data centers próprios e construídos especificamente para esse fim.
O Paradoxo da Capacidade
Eis o que muitos observadores não percebem: O anúncio do investimento de capital de US$ 220 bilhões da Amazon veio acompanhado de um alerta. — a empresa ainda enfrenta limitações de capacidade, apesar do investimento recorde. As limitações não são de silício; são de aço, fibra e energia. Obter as licenças e conectar um projeto de 500 MW à rede elétrica leva de três a cinco anos. É por isso que os hiperescaladores estão apostando na integração vertical — controlar cada camada ou perder para quem o fizer.
Capítulo 2: O que os 220 bilhões de dólares realmente compram?
O investimento de US$ 220 bilhões da Amazon em inteligência artificial não é apenas um número — é uma obrigação de construção. Veja para onde esse dinheiro está sendo direcionado:
Para onde irá o investimento de capital em hiperescala em 2026
| Categoria | Prioridade de Investimento | Impacto na infraestrutura |
|---|---|---|
| Clusters de computação com GPU | Nvidia GB200 NVL72 / Blackwell Ultra | Mais de 120 kW por rack; requer refrigeração líquida e cabeamento de ultra-alta densidade. |
| Infraestrutura de energia | Subestações dedicadas, geração no local. | 300–500 MW por campus; projeto personalizado de painéis elétricos e redundância. |
| Silício Personalizado | Trainium, Graviton, MaaS, MTIA | Diferentes perfis de potência/térmicos; racks projetados para fins específicos. |
| Tecido de Rede | Spine de 800G/1.6T, RDMA sobre Ethernet Convergida | Contagem alta Fibra MPOCabos DAC/AOC, switches de latência ultrabaixa |
| Imóveis e obras civis | Aquisição de terrenos, licenciamento, construção da estrutura | Prazos de entrega de 3 a 5 anos; vantagem geográfica para pioneiros. |
Os clusters de IA exigem arquiteturas de cabeamento projetadas especificamente para essa finalidade — desde switches de topo de rack até troncos de fibra óptica entre linhas, com capacidade para 800G e superiores.
Capítulo 3: A Perspectiva da Infraestrutura de Cabeamento Sobre a Qual Ninguém Fala
Quando a imprensa especializada aborda os gastos com hiperescala, o foco geralmente está na quantidade de GPUs e na capacidade de energia. Mas a rede é o sistema nervoso desses clusters — e a infraestrutura de cabeamento é onde a teoria se encontra com a prática para o desempenho no mundo real.
A densidade de racks está reescrevendo os padrões de cabeamento.
O aumento da densidade modal de potência em rack de 9 kW para 11 kW parece incremental. Na prática, significa:
- Os limites do PoE em cabos de cobre estão sendo testados sob condições extremas. — Com 11 kW, mesmo o Cat6A apresenta dificuldades no gerenciamento térmico dentro de feixes densos. Nosso guia de cabeamento PoE++ Este texto aborda os cálculos sobre o tamanho seguro dos feixes de partículas em níveis de potência elevados.
- curto alcance Cabos DAC e AOC estão deslocando transceptor+cabo de remendo combinações — Em racks de IA, a distância entre o switch e a GPU geralmente é inferior a 3 metros, tornando o DAC a opção mais econômica e com menor latência.
- Tronco de fibra MPO Os números estão disparando. — As portas de switch de 800G usam NRZ de 16×56G ou PAM4 de 8×10⁶G, exigindo arrays MPO de 12 ou 24 fibras por porta.
- Densidade de remendos de fibra no final da fileira está se tornando uma limitação física — Em switches de 48 portas 800G com breakout MPO, um único gabinete de fim de linha pode terminar milhares de fibras. O gerenciamento de fibras limpo, etiquetado e de fácil manutenção deixou de ser opcional.
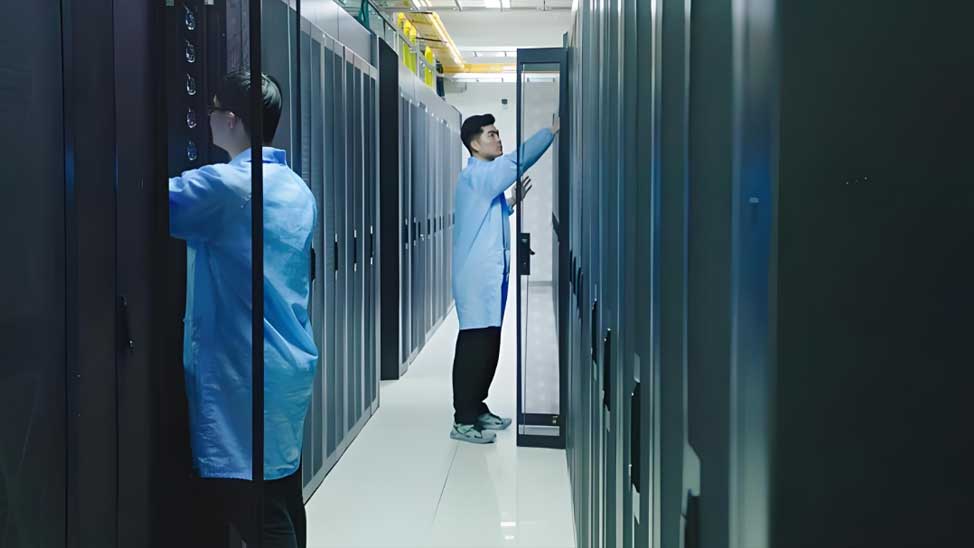
Ambientes com cabeamento de alta densidade exigem um planejamento cuidadoso de gerenciamento térmico — cada watt economizado em refrigeração representa um watt economizado em custos de infraestrutura.
Capítulo 4: Geografia, Água e o Novo Cálculo de Seleção de Sítios
Não se trata apenas de construir — trata-se de construir ondeA mesma análise que apontou o gasto de US$ 220 bilhões em IA também destacou uma verdade incômoda: A água está se tornando a nova terra..
Os data centers de IA não consomem apenas muita energia — eles também consomem muita água. As torres de resfriamento evaporam milhões de litros por mês. Comunidades nos EUA, como Virgínia, Texas e Arizona, já estão se mobilizando contra o consumo de água dos data centers. O resultado: os hiperescaladores estão tomando decisões geográficas com base nos direitos de água, e não apenas na disponibilidade de energia.
Prioridades de infraestrutura para corredores de hiperescala emergentes
| Fator | Prioridade Tradicional | Prioridade 2026+ |
|---|---|---|
| Energia | Confiabilidade (tempo de atividade superior a 99.99%) | Capacidade disponível (mais de 500 MW por campus) |
| Conectividade | Neutralidade de operadora, Salas de Encontro | Troca de nuvem na mesma rede, fibra privada para campi. |
| Água | Geralmente ignorado | Essencial: direitos de acesso, reciclagem de águas residuais |
| Permitindo | 6 a 12 meses | 12 a 24 meses; envolvimento da comunidade necessário |
| Infraestrutura de cabeamento | Cabeamento estruturado padrão | Com recursos de IA: integração de refrigeração líquida, troncos de fibra óptica prontos para 800G. |
Essa diversificação geográfica criará novos corredores de data centers — e novas oportunidades para fornecedores de infraestrutura que conseguirem se adaptar rapidamente aos mercados emergentes.
Centros de rede de alta velocidade exigem um gerenciamento meticuloso de fibra óptica: troncos MPO com código de cores, identificação clara e proteção contra curvaturas em cada trecho.
Capítulo 5: O que isso significa para compradores corporativos e parceiros de canal
A onda de autoconstrução em hiperescala não é apenas uma história sobre a Amazon e o Google. Ela está remodelando todo o ecossistema de data centers — e os impactos já estão chegando aos departamentos de compras das empresas.
Para equipes de TI e redes corporativas
Se o seu provedor de colocation está investindo repentinamente em salas dedicadas à IA e infraestrutura de refrigeração líquida, isso é um bom sinal — eles estão se adaptando. Mas, caso contrário, suas cargas de trabalho de IA podem enfrentar longos tempos de espera ou custos adicionais. Nosso guia de conexão direta Cat8 Abrange os requisitos de cabeamento de cobre para clusters de inferência de IA de 40G/100G empresariais que se conectam a nuvens hiperescaláveis.
Para empreiteiros e integradores de cabeamento
A lacuna de competências está a aumentar. A instalação de cablagem estruturada num centro de IA de nível hiperescalável requer:
- Familiaridade com Fibra pré-terminada MPO/MTPr e gerenciamento de polaridade
- Compreensão de Comparação entre DAC e AOC para diferentes topologias intra-rack
- Conhecimento de ambientes de resfriamento líquido — entrada de umidade, classificações de revestimento de cabos (LSZH vs. plenum) e roteamento de corredor frio vs. corredor quente
- Certificação para TIA-942 e familiaridade com Requisitos de nível do Uptime Institute
Capítulo 6: A Perspectiva do Fornecedor de Cabeamento — Como a AMPCOM se Encaixa
À medida que os provedores de hiperescala constroem sua própria infraestrutura, eles ainda precisam de componentes de alta qualidade — e precisam deles em volumes e especificações que as compras corporativas padrão não conseguem fornecer. A posição da AMPCOM nesse cenário é estratégica:
- Conectividade de fibra óptica com nível de IA — Nossos conjuntos de troncos MPO, adaptadores LC/SC e painéis de conexão de fibra óptica são classificados para ambientes de data center de 800G+.
- Cabos de cobre PoE de alta potência — Cabos Cat8 e Cat7A com classificação PoE de 100 W ou superior e desempenho térmico adequado em configurações de feixe.
- Soluções DAC e AOC — Cabos de cobre e ópticos ativos de conexão direta para aplicações de curto alcance entre GPU e switch
- Soluções de fibra personalizadas — Da AMPCOM programa de fibra personalizado Suporta contagens MPO não padronizadas, troncos híbridos de cobre/fibra e roteamento de fibra específico para aplicações em implantações de hiperescala e colocation.
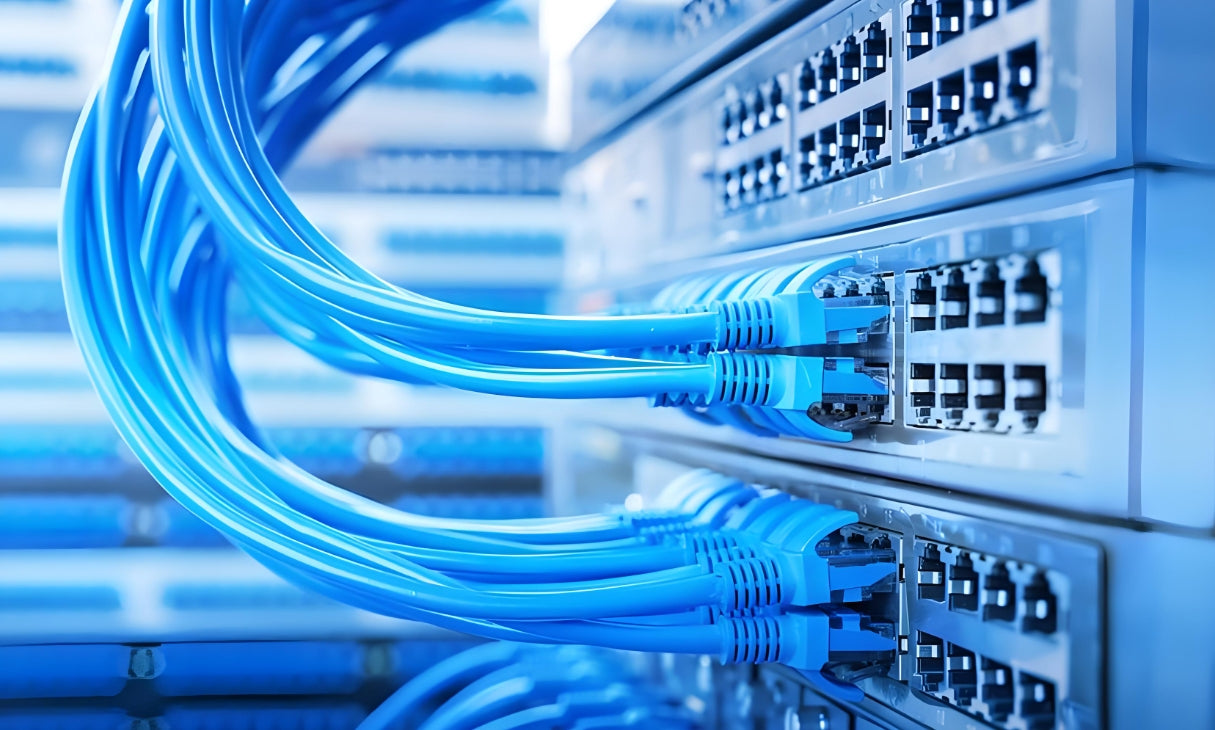
A cablagem estruturada para infraestruturas de nível de IA requer componentes especializados e conhecimentos de instalação específicos — desde a gestão de fibras MPO até ao encaminhamento de cabos com otimização térmica.
Capítulo 7: Principais Conclusões e Perguntas Frequentes
🔑 Pontos importantes
- US$ 220 bilhões em investimentos de capital em IA É uma exigência de construção, não apenas um gasto com tecnologia — os provedores de hiperescala estão construindo campus específicos porque a colocation padrão não consegue lidar com racks de GPUs de mais de 120 kW.
- A mudança de paradigma "comprar versus construir" é impulsionado pela densidade de potência, complexidade de refrigeração e requisitos de latência para os quais os data centers de uso geral nunca foram projetados.
- Densidade de racks saltando de 9 kW para 11 kW Está a reescrever os cálculos térmicos da cablagem — os limites dos feixes Cat6A, a quantidade de fibras MPO e as escolhas entre DAC e transceptor precisam de ser reavaliados para cargas de trabalho de IA.
- A água é a nova terra — As decisões geográficas agora são influenciadas tanto pelos direitos de água quanto pela disponibilidade de energia, criando novos corredores para centros de dados.
- Cabeamento estruturado para IA É uma disciplina especializada — o gerenciamento de fibra MPO, a integração de refrigeração líquida e a infraestrutura preparada para 800G exigem contratados com treinamento específico em IA.
Perguntas frequentes
P: A tendência de autoconstrução em hiperescala vai eliminar os provedores de colocation?
Não — na verdade, a pesquisa de 2026 do Uptime Institute mostra que os serviços gerenciados/de colocation atingirão 46%, agora ligeiramente à frente das instalações próprias das empresas, com 44%. Os provedores de hiperescala estão construindo infraestrutura para suas próprias cargas de trabalho de IA; empresas de grande e médio porte continuarão a depender de colocation e nuvem para obter flexibilidade e eficiência de capital.
P: Que infraestrutura de cabeamento é necessária para racks de GPUs de 120 kW ou mais?
Com 120 kW por rack, o cabeamento de cobre tradicional atinge rapidamente os limites térmicos. As melhores práticas incluem: usar Cat8 ou Cat7A com a bitola adequada (mínimo de 23 AWG para PoE), limitar o tamanho dos feixes com base na modelagem térmica, considerar o uso de DAC/AOC para conexões intra-rack de curto alcance e integrar roteamento de cabos seguro para tubulações de refrigeração em instalações com refrigeração líquida.
P: Como a onda de gastos com hiperescala afeta minha decisão de atualização da rede corporativa?
Duas implicações práticas: (1) Sua infraestrutura de conectividade em nuvem deve ser dimensionada para 100G+ daqui para frente, já que os serviços de IA em hiperescala exigirão cada vez mais conexões de alta largura de banda e baixa latência. Cabos de cobre Cat8 para conexões diretas e fibra multimodo OM4/OM5 ou monomodo OS2 para longas distâncias são o padrão. (2) Planeje a infraestrutura de cabeamento com capacidade para 800G — o ciclo de transição está se acelerando.
P: Por que a água está se tornando um gargalo para a expansão de data centers?
Os data centers modernos utilizam resfriamento evaporativo (torres de resfriamento) que consomem milhões de litros de água por mês. À medida que os campus de IA crescem para 300–500 MW — o tamanho de uma pequena cidade — o consumo de água se torna uma questão comunitária e regulatória. Os provedores de hiperescala agora avaliam os direitos de uso da água, a reciclagem de águas residuais e o potencial de economizadores de ar como parte da seleção de locais, juntamente com as métricas tradicionais de disponibilidade de energia e conectividade de fibra.
Equipe Técnica da AMPCOM
Especialistas do setor com mais de 17 anos de experiência em cabeamento estruturado, infraestrutura de data center e projeto de redes de fibra óptica.
Precisa de soluções de cabeamento para infraestrutura de nível de IA?
A AMPCOM fornece conectividade de fibra e cobre pronta para hiperescala — desde conjuntos de troncos MPO até cabos de conexão Cat8 PoE++ — projetados para ambientes de data center de 800G+.
Explore soluções de cabeamento de nível IA

